

Data Management Plan
Che cos'è un data management plan
Il data management plan (DMP) è uno strumento che aiuta i ricercatori già all’inizio di un progetto a preventivane e pianificarne l’intero ciclo di vita del progetto, con particolare riferimento alla gestione dei dati della ricerca.
Il DMP è un deliverable di progetto (cioè un documento o altro, che deve essere consegnato al committente e all’ente finanziatore come evidenza delle attività svolte) ma anche un elemento di valutazione per l'approvazione del finanziamento (ad esempio in Horizon Europe). Con il DMP il focus del ricercatore si sposta dalla pubblicazione finale (anch’essa importante) alla gestione del progetto di ricerca e dei dati trattati. Si tratta di un documento dinamico, che in Horizon Europe deve essere aggiornato ogni volta che è necessario (in Horizon 2020 erano previsti tre momenti di aggiornamento del documento), contiene la codifica di tutte le regole stabilite per la gestione dei dati e dei documenti di progetto, oltre che le motivazioni che porteranno a rendere aperti o no i dati della ricerca, secondo il principio "as open as possibile, as closed as necessary".
Gli enti finanziatori hanno bisogno di un DMP perchè il ricercatore deve dimostrare consapevolezza su una buona gestione dei dati, secondo i principi FAIR, e una disponibilità alla condivisione dei dati che, per essere resa possibile, comporta l’adozione consapevole di standard largamente diffusi, una chiara documentazione e una adeguata allocazione delle risorse umane, tecniche ed economiche, una garanzia di conservazione (e riuso) a lungo termine.
Il DMP deve essere specifico per l’argomento trattato dal progetto di ricerca, sintetico e schematico, perché siano facilmente utilizzabili le istruzioni per l’utilizzo dei dati trattati. Non bisogna inserire informazioni generiche e vaghe, ma informazioni specifiche sul progetto in corso, con dati reali e riscontrabili, perché sia realmente uno strumento di lavoro prima di tutto per il gruppo di progetto, poi per chi volesse riutilizzare i dati per altri progetti. La precisione sui dati trattati è fondamentale anche per una corretta valutazione dei costi riguardanti la gestione dei dati (consulta gli articoli specifici in questo sito).
Come si compila il Data Management Plan
Il DMP si divide in varie sezioni che coprono l’intero ciclo di vita dei dati. Esistono vari template per la stesura di un DMP e ogni volta bisogna scegliere quello che più si adatta alle caratteristiche del progetto. In ogni caso ci sono delle caratteristiche comuni a tutti i template, che sono state ben identificate nel documento “Practical Guide to the International Alignment of Research Data Management - Extended Edition” (Science Europe. (2021). Practical Guide to the International Alignment of Research Data Management - Extended Edition. https://doi.org/10.5281/zenodo.4915862) di Science Europe.
Le immagini che seguono ne rappresentano graficamente il contenuto (elaborazione grafica a cura del Settore Servizi per la ricerca e diffusione della conoscenza scientifica, UniPA):
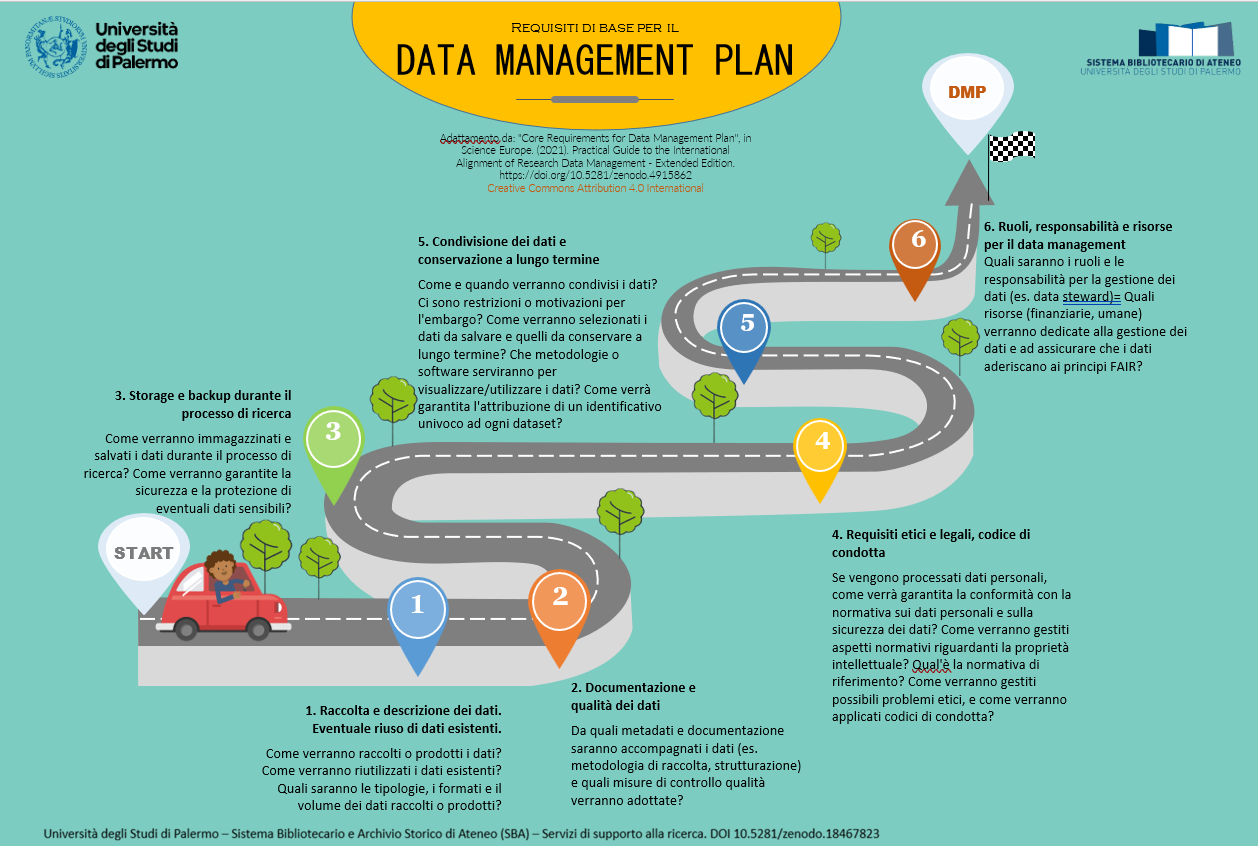
Sempre nel documento “Practical Guide to the International Alignment of Research Data Management - Extended Edition” (Science Europe. (2021). Practical Guide to the International Alignment of Research Data Management - Extended Edition. https://doi.org/10.5281/zenodo.4915862) di Science Europe, i requisiti di base vengono esplicitati come segue:
START |
Inserisci le informazioni relative a nome richiedente, codice progetto, programma di finanziamento, versione del DMP. |
1 |
|
2 |
|
3 |
|
4 |
|
5 |
|
6 |
|
Scopri i principali strumenti online per la compilazione del DMP
In rete sono disponibili dei wizard per la composizione del DMP, ad esempio DMP Online (vai alla guida operativa SBA UniPA), Data Stewardship wizard (vai alla guida operativa SBA UniPA), oppure ARGOS (vai alla guida operativa SBA UniPA).
IlDMP Online (https://dmponline.dcc.ac.uk/) è un software open source ed è personalizzabile. Ad esempio sarebbe possibile precompilare alcune sezioni come il codice etico o altre politiche di Ateneo che valgono per tutti i progetti di ricerca. Offre una dashboard che consente di conservare i propri documenti.
Nella sezione OA@UniTO dell’Università di Torino dal titolo “Come scrivere un Data Management Plan”, sono presenti due video della dott.ssa Elena Giglia: il primo spiega come utilizzare il DMP Online e il secondo spiega l'utilizzo del Data Stewardship Wizard (https://ds-wizard.org/).
Nel DMP online, la prima sezione è quella dei dati dell’ente, con funzionalità di collegamento a codifiche internazionali, come ad esempio l’ORCID del principal investigator, il grant number, l’acronimo del progetto, ecc.. Si possono utilizzare dei modelli preconfezionati, ad esempio quello della Commissione Europea per Horizon 2020 (in questo caso sono disponibili nelle 3 versioni previste, iniziale, intermedia e finale, con relativa guida contestuale) o Science Europe. Il wizard è predisposto per il lavoro di gruppo, mediante condivisione con altri utenti, e consente di effettuare il download del documento compilato. I campi da compilare sono corredati da help contestuale e l'utente viene guidato nella compilazione di tutte le parti che garantiranno che i dati rispondano ai requisiti FAIR.
Il wizard comprende anche la parte di allocazione della risorse, sia finanziarie che umane, ricordando di inserire tutte le voci di costo che saranno poi rimborsabili da parte dell’ente finanziatore; inoltre comprende la parte relativa alla sicurezza dei dati, che potrebbe essere precompilata nel caso in cui l’Ateneo avesse già predisposto delle procedure standard in merito. Nella parte che riguarda aspetti etici e legali sui dati si possono indicare eventuali riferimenti a vincoli imposti dal GDPR ed eventuali consensi informati necessari per poter trattare i dati.
Al termine della composizione del DMP online è possibile scaricare un file con le formattazioni di massima impostate con il wizard, in formato html, pdf, txt, csv, ecc.
|
Tabella comparativa strumenti per il DMP Online |
||
| DMP Online
https://dmponline.dcc.ac.uk/ |
Data Stewardship wizard https://ds-wizard.org/ |
Argos https://argos.openaire.eu/ |
| DMP Online, pur guidando nella compilazione, presenta di fatto una pagina bianca in cui bisogna scrivere i contenuti, che possono essere testo libero, tabelle ed elenchi puntati. In ogni passaggio è possibile salvare per continuare dopo.
Mette a disposizione i template di Horizon e di Science Europe, oltre ad altri template personalizzati. Presenta un help contestuale, con consigli specifici e link a strumenti esterni, ad esempio per i formati di dati raccomandati Offre dei videotutorial. Consente la scrittura collaborativa. Il DMP prodotto è machine readable ed è possibile esportarlo in diversi formati standard. |
Propone all’utente una serie di domande guidate e alla fine genera il DMP. Consente di utilizzare knowledge model differenti, con domande specifiche per il dominio di ricerca. Mette a disposizione i template di Horizon e di Science Europe, oltre ad altri template personalizzati. Il wizard è molto dettagliato, tiene conto di tutte le sezioni del DMP. Crea una “to do list” per gli aspetti non definiti, visualizzata contestualmente. A seconda delle risposte date, continua con una diramazione di domande coerenti con la risposta precedente. Comprende il supporto per l’individuazione delle licenze d’uso dei dati. Presenta un help contestuale che rimanda al libro di Barend Mons. Fornisce anche spunti di autovalutazione sugli aspetti che rendono i dati FAIR. Offre dei videotutorial. Consente la scrittura collaborativa. Il DMP prodotto è machine readable e anche machine actionable. A partire dalla compilazione delle domande, in maniera trasparente per l’utente genera un DMP in cui sono compilate tutte le sezioni in maniera pertinente. N.B. Non è necessario installare il software localmente:
|
Argos propone all’utente una serie di domande guidate ma consente anche di compilare del testo proprio. Mette a disposizione i template di Horizon e di Science Europe, oltre ad altri template personalizzati. Consente di associare più dataset allo stesso DMP. Il DMP prodotto è machine readable e anche machine actionable. Tratta l’argomento delle licenze d’uso in maniera particolarmente dettagliata. Richiede comunque integrazione manuale delle informazioni all’utente. Non fornisce warning o elementi di autovalutazione delle informazioni inserite rispetto al rispetto dei principi FAIR. E’ connesso ad Openaire Research Graph, che contiene link tra dati e pubblicazioni. |
|
Vai alla Guida operativa SBA UniPA:
|
Vai alla Guida operativa SBA UniPA:
|
Vai alla Guida operativa SBA UniPA:
|
|
|
|
|
Riferimenti: Open Science cafè del 12 gennaio 2023 (https://www.icdi.it/it/news/197-come-scrivere-un-dmp)
Altre domande guida utili per la redazione del DMP si possono ritrovare nel sito CESSDA, nella pubblicazione Adapt your Data Management Plan - A list of Data Management Questions based on the Expert Tour Guide on Data Management (https://www.cessda.eu/content/download/4302/48656/file/TTT_DO_DMPExpertGuide_v1.2.pdf).
Altre risorse e strumenti online per la redazione del DMP
Di seguito vengono elencate numerose risorse da consultare:
-
Guide al DMP
-
Science Europe Practical Guide to the International Alignment of Research Data Management (2021)
-
DMP tips and tricks (2021)
-
CESSDA Adapt your DMP (2019)
-
Strumenti online per scrivere un DMP
-
DMP online con un modello per Horizon 2020 e Science Europe - Video tutorial su come utilizzarlo
-
Data wizard con un modello per Horizon 2020 e Science Europe - Video tutorial su come utilizzarlo
-
DMP tool per funder USA
-
Strumento di autovalutazione per un DMP
-
NWO rubric
-
Esempio di Data Management Plan
Come fare una buona gestione dei dati (RDM o Research Data Management) in un progetto di ricerca
La gestione dei dati della ricerca è prevista nella direttiva open data “Direttiva europea 2019/1024 del Parlamento europeo e del Consiglio del 20 giugno 2019 (https://eur-lex.europa.eu/legal-content/IT/TXT/PDF/?uri=CELEX:32019L1024) , relativa all’apertura dei dati e al riutilizzo dell’informazione nel settore pubblico” (Gazzetta ufficiale dell’Unione Europea del 26.6.2019), recepita in Italia con il decreto legislativo n. 200 dell’8 novembre 2021, entrato in vigore il 15 dicembre 2021, atteso provvedimento relativo all’apertura dei dati e al riutilizzo delle informazioni del settore pubblico. Maggiorni dettagli sugli indirizzi normativi alla pagina Progetti con finanziamenti pubblici.
Alla luce di questi provvedimenti rivestono grande importanza le politiche di Ateneo a supporto della gestione dei dati e della loro sicurezza, intesa sia come sicurezza da attacchi esterni, sia come sicurezza nelle conseguenze relative alla diffusione dei dati.
Fare una buona gestione dei dati è utile e produttivo in primis per lo stesso gruppo di ricerca, ma anche per potenziali fruitori futuri. Nella gestione dei dati sono fondamentali i backup, un eventuale software di accompagnamento per la loro lettura (ad esempio nel caso in cui si tratti di un particolare formato, anche proprietario), la presenza di una legenda (o comunque una documentazione che spieghi la natura e le modalità di calcolo di ogni singolo metadato). In generale per una maggiore consapevolezza sulle attività da svolgere per una buona gestione dei dati, può essere utile la lettura dell’OpenAIRE RDM handbook.
Un validissimo supporto è rappresentato dalle guide predisposte dall'Università degli Studi di Bologna e disponibili alla pagina web Linee guida di Ateneo per la gestione dei dati della ricerca. Le guide sono modulari e trattano sia il ciclo di vita dei dati in un progetto di ricerca che le diverse sfaccettature dell'argomento.
Si segnala consultazione del portale “OPEN-SCIENCE.IT La scienza condivisa” (https://open-science.it/), una recente iniziativa italiana portata avanti dall’ ICDI (Italian Computing and Data Infrastructure), un tavolo tecnico creato dai rappresentanti di alcune tra le principali Infrastrutture di Ricerca e Infrastrutture Digitali italiane con l’obiettivo di promuovere sinergie a livello nazionale al fine di ottimizzare la partecipazione italiana alle attuali sfide europee in questo settore, tra cui anche la European Open Science Cloud (EOSC). Il portale rappresenta uno strumento in cui trovare informazioni generali, materiale formativo, novità e aggiornamenti di carattere sia nazionale che internazionale. Nel portale sono inoltre reperibili notizie di eventi e novità rilevanti nel movimento dell’Open Science con una prospettiva internazionale e una specifica attenzione all’Italia.
Altrettanto utile strumento per i ricercatori è il manuale S-Legami!: Open Access – Manuale d’uso per i ricercatori dell’Agenzia per la Promozione della Ricerca Europea (APRE). La seconda edizione disponibile al seguente link https://apre.it/wp-content/uploads/2022/04/S-Legami_seconda-edizione_final_con-codici.pdf contiene svariati contenuti legati all’Open Science.
Per un elenco di strumenti di supporto e utili letture per la gestione dei dati del progetto di ricerca, si consiglia di consultare la sezione "Strumenti e pratiche l'open science".
La stima dei costi per la gestione dei dati nel progetto di ricerca
La pianificazione dei costi rappresenta una componente fondamentale del Data Management Plan (DMP). La gestione dei dati di ricerca, infatti, richiede non soltanto l'individuazione delle attività da svolgere durante il ciclo di vita dei dati, ma anche una valutazione preventiva delle risorse umane, tecniche e finanziarie necessarie per realizzarle.
È quindi opportuno effettuare questa valutazione già nella fase di progettazione della ricerca. OpenAIRE (https://www.openaire.eu/what-will-it-cost-to-manage-and-share-my-data) sottolinea che le attività di gestione e condivisione dei dati devono essere considerate in termini di tempo e risorse e che una pianificazione anticipata può contribuire a ridurre significativamente i costi.
I costi non riguardano esclusivamente lo storage. Possono derivare dalle diverse attività che accompagnano i dati lungo il loro ciclo di vita, tra cui:
- acquisizione e organizzazione dei dati;
- trascrizione e digitalizzazione;
- descrizione dei dati e produzione dei metadati;
- documentazione;
- storage e backup;
- sicurezza e controllo degli accessi;
- anonimizzazione o pseudonimizzazione;
- conversione dei formati;
- data cleaning;
- gestione degli aspetti legati al copyright;
- preparazione dei dataset per il deposito e la condivisione;
- conservazione e archiviazione;
- impiego di personale specializzato, compreso un eventuale data manager.
Un aspetto particolarmente importante è la distinzione tra risorse già messe a disposizione dall'istituzione e servizi o infrastrutture aggiuntivi che devono invece essere finanziati dal progetto. Per esempio, storage e backup istituzionali possono rientrare nei costi indiretti, mentre capacità di archiviazione aggiuntiva, hardware, software o servizi specialistici possono generare costi ulteriori.
Un interessante articolo su openAIRE, “How to identify and assess Research Data Management (RDM) costs” (https://www.openaire.eu/how-to-comply-to-h2020-mandates-rdm-costs), consente di valutare i costi del proprio progetto utilizzando lo strumento Estimating costs RDM tool (https://www.openaire.eu/how-to-comply-to-h2020-mandates-rdm-costs). Il tool pone delle domande dettagliate.
Fonte: OpenAIRE. How to identify and assess Research Data Management (RDM) costs. 2020. https://www.openaire.eu/how-to-comply-to-h2020-mandates-rdm-costs
Alla sezione "Strumenti e pratiche per l'open science" sono descritti diversi strumenti online per la stima dei costi.
La figura del data steward
Nel documento Strategic Research and Innovation Agenda (SRIA) - EOSC (EOSC-SRIA-V1.0_15Feb2021.pdf,https://eosc.eu/sites/default/files/EOSC-SRIA-V1.0_15Feb2021.pdf), la presenza della figura del data steward, nelle organizzazioni che si occupano di ricerca, viene menzionata tra i fattori critici di successo per la realizzazione degli obiettivi. Il data steward è una figura professionale specializzata nell’implementazione delle politiche open access, linee guida e programmi di realizzazione, a supporto dell’intero processo di ricerca, realizzando pienamente gli obiettivi di EOSC ([…]the European Open Science Cloud is a process, not a project[…], in The Vienna Declaration on the European Open Science Cloud, https://eosc-launch.eu/declaration/).
Nel booklet “Data Steward: Minimum Viable Skills Profile” viene presentato il […] Minimum Viable Skillset (MVS) per i Data Steward, essenziale per implementare i principi della scienza aperta e supportare l'European Open Science Cloud. L'MVS delinea due varianti di ruolo: "Coordinator" e "Embedded" Il ruolo di "Coordinator" supporta i domini di ricerca di un'organizzazione, mentre il ruolo di "Embedded" opera a stretto contatto con specifici team di ricerca e con le loro pratiche di settore. Questi ruoli possono sovrapporsi a seconda delle risorse, delle esigenze disciplinari e della cultura organizzativa. […] ((Hansen, K. K., White, A., Horton, L., Koteska, B., Rauste, P., & van Leersum, N. (2025). Data Steward: Minimum Viable Skills Profile. Zenodo. https://doi.org/10.5281/zenodo.16760455)).
Secondo il profilo Data Steward Minimum Viable Skills Profile di Skills4EOSC (https://www.skills4eosc.eu/resources/publications/mvs), il/la data steward è la figura che lavora con gli stakeholder per stabilire, governare e mantenere processi che rendano i dati di ricerca utilizzabili, di qualità, archiviabili e riutilizzabili, supportando decisioni informate sul corretto grado di apertura nel rispetto di aspetti etici, legali e sociali. Il framework distingue inoltre una dimensione più coordinativa/istituzionale e una più “embedded”, vicina ai gruppi di ricerca.
Il profilo del data steward presuppone una competenza di dominio sui dati (ad esempio le caratteristiche dei reperti archeologici, le caratteristiche dei dati diagnostici effettuati con determinati macchinari, ecc.) oltre a competenze tecniche per il trattamento dei dati della ricerca, secondo i principi FAIR.
La figura del data steward può essere declinata in modi diversi: tecnico, sviluppatore, agente del cambiamento (https://findresearcher.sdu.dk:8443/ws/portalfiles/portal/160501865/National_Coordination_of_Data_Steward_Education_in_Denmark_Final_report_to_the_National_Forum_for_Research_Data_Management_DM_Forum_Results_and_recommendations_Janua_002_.pdf).
Un’altra interpretazione della figura del data steward può essere consultata sul sito https://www.itware.com/blog-itware/big-data-analytics-data-management/item/1311-data-steward-per-mestiere-piu-semplice-che-data-analyst-piu-di-valore-per-l-impresa.
I modelli per questa professionalità più approfonditi sono quelli danese e olandese. Da un report danese (Final report to the National Forum for Research Data Management, Zenodo: https://doi.org/10.5281/zenodo.3609515), emergono tre profili:
- policy data stewards: si focalizzano su regolamenti e linee guida istituzionali, relazionandosi con politici, enti finanziatori, management di ricerca e universitario);
- research data stewards: sono esperti di data mangement in una specifica disciplina e lavorano nel gruppo di ricerca;
- infrastructure data stewards: si occupano dell’infrastruttura tecnica che ospita i FAIR data.
Tali profili spesso nella pratica si intersecano.
Tra le attività che possono garantire una buona gestione dei dati del progetto, i data stewart possono offrire:
• Attuazione della policy di Ateneo per la gestione dei dati e delle eventuali policy specifiche adottate dai Dipartimenti, in aderenza alle buone prassi legate alle specificità del dominio dei dati di un particolare settore disciplinare
• Attuazione delle policy sui dati come richieste dagli enti finanziatori (interessante una pagina del sito TUDelft con l’elenco aggiornato dei maggiori enti europei e della relativa documentazione https://www.tudelft.nl/en/library/data-management/research-data-management/funders-policies-for-research-data)
• Impostazione dell'archiviazione sicura dei dati
• Consigli su buone pratiche di gestione dei dati
• Informazioni sull'archiviazione dei dati
• Suggerimenti per aumentare l'impatto con la condivisione dei dati
• Preparazione di piani di gestione dei dati
• Eventuali altre attività legate alla gestione dei dati
Aspetti normativi: A proposito dell'introduzione della figura del data steward nel nostro Paese, il Piano nazionale della scienza aperta in Italia (PNSA), approvato nei primi mesi del 2022 con Decreto Ministeriale n. 268 del 28/02/2022, prevede, nell’asse di intervento n. 2 (Dati della ricerca), tra i piani di intervento, una sezione dedicata alla “Formazione delle figure tecniche”. In particolare, tra gli obiettivi per questo asse di intervento, è inserita […]“la formazione e assunzione di risorse umane qualificate per i ruoli di scienziato dei dati (data scientist) per lo sviluppo di architetture e servizi, e di tecnico-amministratore dei dati (data steward) per la cura, descrizione, identificazione e archiviazione degli insiemi di dati;” […] e […] “l’implementazione di metodi e protocolli specifici per la verifica della qualità dei dati, degli archivi e dei servizi, e per la regolamentazione degli aspetti etici e legali;”[…]. Inoltre, il PNSA, tra gli stessi obiettivi, si propone di […] “• valutare, in risposta alla necessità rappresentata dalla comunità, la creazione di un’infrastruttura nazionale per i dati della ricerca e gli archivi, ottimizzando le risorse esistenti ed aprendo nuovi servizi a tutte le organizzazioni e discipline anche per favorire la collaborazione e la interdisciplinarità.” […]
Riguardo alle risorse, le “Azioni da attivare” elencate nel PNSA sono:
[…]
A cura del MUR (e degli altri Ministeri con attività di ricerca):
a. consolidare l’indagine conoscitiva, avviata in ambito EOSC (Landscape), sullo stato dell’arte delle IR, degli EPR e degli Atenei per quanto riguarda le pratiche di gestione dei dati FAIR;
b. supportare ICDI, quale soggetto titolato a rappresentare la comunità italiana all’interno della EOSC association;
c. inserire in tutti i bandi finanziati con fondi pubblici le prescrizioni per la produzione di dati FAIR e il loro deposito in archivi aperti certificati;
d. favorire lo sviluppo coerente di percorsi formativi universitari per “data scientist” e “data steward”, con accreditamento europeo anche mettendo a sistema le competenze delle IR e degli EPR;
e. valorizzare le sinergie con le IR nazionali ed europee e con i loro servizi ai dati già esistenti anche al fine di una rendicontazione completa e trasparente dei contributi dell’Italia all’EOSC;
f. attuare l’art. 10 della Direttiva UE 2019/1024 del 20 giugno 2019 relativa all’apertura dei dati e al riutilizzo dell’informazione del settore pubblico;
g. supportare a livello nazionale i processi di certificazione per dati FAIR;
h. sostenere gli investimenti per FAIR-by-design;
i. inserire nei bandi per progetti di ricerca la clausola di produzione di dati FAIR;
j. prevedere la copertura dei costi relativi e inserirli all’interno dei costi ammissibili;
k. adottare un archivio dei dati di riferimento e delle politiche di gestione dei dati, o verificare l’allineamento di quelle esistenti ai criteri FAIR, anche in vista di certificazione;
l. pubblicare annualmente dati e statistiche in forma di dati aperti sullo stato di attuazione dei principi FAIR e di apertura dei dati;
m. avviare la formazione di base per tutti i ricercatori e tecnologi sulla gestione dei dati FAIR;
n. estendere a tutti i curriculum formativi una alfabetizzazione all’utilizzo dei dati della ricerca;
o. investire in servizi di supporto per gli aspetti giuridici della gestione dei dati;
p. investire in pratiche di cura dei dati finalizzate alla conservazione sul lungo periodo;
q. designare un NPR (National Points of Reference on Scientific Information).
[…]
Cosa è consigliabile verificare prima di pubblicare i dati della ricerca
Prima di procedere alla pubblicazione dei dati del proprio progetto di ricerca, bisogna effettuare una serie di controlli:
-
verificare se i dati aderiscono ai principi FAIR, ad esempio utilizzando la checklist "How FAIR are your data?" (Jones, S., & Grootveld, M. (2017). How FAIR are your data?. https://doi.org/10.5281/zenodo.1065990)
-
verificare l'eventuale presenza di dati personali o sensibili: in questo caso bisogna provvedere alla anonimizzazione, con strumenti come ad esempio Amnesia
-
verificare con l’editore la politica di disponibilità dei dati a corredo dell’articolo scientifico che si sta pubblicando
-
assicurarsi che siano dotati di un identificativo persistente (es. DOI), per garantire che i dati siano reperibili (findable)
-
assicurarsi che i dati espongano un “data access statement”, cioè che, oltre all’identificatore persistente, siano accompagnati da informazioni che li descrivano e che diano notizie sulle modalità di accesso e sugli eventuali vincoli per il loro utilizzo (es. file README)
-
assicurarsi che i dati espongano una licenza di utilizzo per l’utente finale. Per i dati è possibile scegliere tra innumerevoli tipi di licenze, che devono essere standard (cfr. http://opendefinition.org/licenses/) per poter essere chiaramente comprese dall’utente finale e per rendere i dati reusable, sempre nell’ottica dei principi FAIR. Nel caso di software è possibile consultare questo elenco di licenze possibili
-
esporre i dati in un formato di file aperto e standard, per assicurarsi, in conformità ai principi FAIR, che siano reusable e interoperable. Molti data repository espongono la lista dei formati di file consigliati/preferiti a seconda della tipologia di oggetti archiviati (immagini, testi, database, audio, video, ecc.). Oltre ai formati semplici più diffusi, un particolare formato di dati utilizzato nel campo della ricerca scientifica è NetCDF (Network Common Data Form), un formato auto descrittivo che include anche metadati generici e specifici machine-readable; questo formato può essere utilizzato in modo avanzato con server che implementano il protocollo OPeNDAP (Open-source Project for a Network Data Access Protocol); con questo protocollo, infatti, la lettura di dataset e subset nei file può essere eseguita senza che sia necessario scaricare l’intero set di dati, si possono effettuare aggregazioni di dataset e subset in un dataset virtuale e si possono effettuare elaborazioni via software accedendo direttamente ai dataset. Nella sezione "Strumenti e pratiche per l'open science" sono disponibili risorse per la ricerca di standard, ontologie, repositories.
Come faccio a sapere se posso rendere disponibili ad accesso aperto i dati del mio progetto di ricerca? Diritto d'autore, banche dati e licenze per i dati della ricerca
Prima di rendere disponibili i dati prodotti o raccolti nell'ambito di un progetto di ricerca è necessario verificare la natura dei dati, la titolarità dei diritti e l'eventuale presenza di vincoli giuridici, etici, contrattuali o derivanti dagli accordi di progetto.
La possibilità di pubblicare un dataset in accesso aperto non dipende, infatti, esclusivamente dal diritto d'autore. Possono assumere rilievo anche:
- il diritto sui generis sulle banche dati;
- i diritti di terzi;
- la protezione dei dati personali;
- gli obblighi di riservatezza;
- gli accordi stipulati con partner o soggetti finanziatori;
- eventuali ulteriori diritti di proprietà intellettuale.
Nella gestione dei dati della ricerca è pertanto opportuno adottare il principio secondo cui i dati devono essere quanto più aperti possibile e chiusi quanto necessario (as open as possible, as closed as necessary), compatibilmente con i vincoli applicabili.
Dati della ricerca e diritto d'autore
È importante distinguere i singoli dati o contenuti dalla banca dati nella quale essi sono organizzati: i dati intesi come fatti, misurazioni o informazioni non acquisiscono automaticamente una tutela mediante diritto d'autore per il solo fatto di essere stati raccolti nell'ambito di un'attività di ricerca, ma occorre verificare se determinati contenuti inclusi nel dataset siano autonomamente protetti dal diritto d'autore o da altri diritti. Una disciplina specifica riguarda invece le banche dati.
Ai sensi della Direttiva 96/9/CE relativa alla tutela giuridica delle banche di dati, una banca dati può essere protetta dal diritto d'autore quando, per la scelta o la disposizione dei suoi contenuti, costituisce una creazione intellettuale propria dell'autore. Tale tutela riguarda la struttura originale della banca dati e non si estende, per questo solo fatto, ai contenuti della banca dati stessa.
Il ricercatore deve quindi considerare separatamente:
- i possibili diritti sui singoli contenuti;
- la possibile tutela autorale della struttura della banca dati;
- l'eventuale esistenza del diritto sui generis sulla banca dati.
- Il diritto sui generis sulle banche dati
Accanto alla tutela mediante diritto d'autore, la normativa europea prevede una specifica forma di protezione denominata diritto sui generis sulle banche dati, o Sui Generis Database Right (SGDR), che costituisce una forma di tutela distinta dal diritto d'autore e può trovare applicazione quando la costituzione della banca dati ha richiesto un investimento sostanziale nell'ottenimento, nella verifica o nella presentazione dei suoi contenuti (consulta l'articolo "Cosa vuol dire Sui Generis Database Right (SGDR)?").
È pertanto importante non confondere le due forme di tutela: il diritto d'autore tutela l'originalità nella scelta o nella disposizione dei contenuti della banca dati, mentre il diritto sui generis protegge, ricorrendone i presupposti di legge, l'investimento sostanziale relativo all'ottenimento, alla verifica o alla presentazione dei contenuti. Le due forme di tutela possono coesistere qualora siano soddisfatti i rispettivi requisiti.
La scelta della licenza
Quando un dataset viene pubblicato in un repository o reso altrimenti disponibile, è opportuno specificare chiaramente a quali condizioni può essere utilizzato e riutilizzato.
Prima di applicare una licenza occorre tuttavia verificare che il soggetto che la attribuisce disponga effettivamente dei diritti necessari. Creative Commons evidenzia, infatti, che il licenziante deve assicurarsi di detenere tutti i diritti necessari e identificare chiaramente eventuali materiali che non siano coperti dalla licenza.
Quando l'obiettivo è favorire il più ampio riutilizzo possibile, può essere preso in considerazione lo strumento CC0 1.0 Universal.
Tale licenza è concepita per consentire al titolare di rinunciare, nella massima misura consentita dalla normativa applicabile, ai diritti interessati dallo strumento. Il relativo testo comprende anche i diritti sulle banche dati. La licenza CC0 non costituisce tuttavia l'unica soluzione giuridicamente possibile per i dati della ricerca.
Anche le licenze Creative Commons 4.0 possono essere applicate alle banche dati soggette a copyright e, ove applicabile, al diritto sui generis. In particolare, il testo legale della Creative Commons Attribution 4.0 International - CC BY 4.0 contiene una disciplina specifica relativa al diritto sui generis sulle banche dati.
La scelta dello strumento deve essere effettuata considerando:
- la natura del dataset;
- la titolarità dei diritti;
- l'eventuale presenza di diritti di terzi;
- le condizioni previste dagli accordi di progetto;
- il grado di apertura e di riutilizzo che si intende consentire.
Licenza e citazione del dataset
La licenza e la citazione di un dataset svolgono funzioni differenti e non devono essere confuse: la licenza infatti stabilisce le condizioni giuridiche alle quali il dataset può essere utilizzato o riutilizzato, la citazione consente invece di identificare la fonte e di riconoscere il contributo di chi ha prodotto e curato i dati.
Anche quando un dataset viene reso disponibile mediante CC0, è pertanto opportuno raccomandarne la corretta citazione come buona pratica di integrità scientifica e di tracciabilità della ricerca. La citazione non deve però essere presentata come una condizione di licenza propria della CC0.
Dati personali e altri vincoli
L'applicazione di una licenza aperta non elimina gli eventuali vincoli derivanti dalla presenza di dati personali, informazioni riservate, diritti di terzi o altre forme di protezione giuridica. Quando il dataset contiene dati personali deve essere considerata la disciplina prevista dal Regolamento (UE) 2016/679 - GDPR, relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali. Per il trattamento dei dati personali nell'ambito della ricerca scientifica costituiscono inoltre un riferimento aggiornato le Guidelines 1/2026 on processing of personal data for scientific research purposes, adottate dall'European Data Protection Board il 15 aprile 2026.
L'attribuzione di una licenza aperta non sostituisce quindi la verifica preliminare della liceità della diffusione dei dati.
Progetti collaborativi
Nei progetti che coinvolgono più partner, e in particolare nei progetti internazionali, è necessario individuare preventivamente chi sia legittimato a decidere sulla pubblicazione e sulle condizioni di riutilizzo dei dati.
Prima di pubblicare un dataset è opportuno verificare:
- la titolarità dei diritti;
- gli accordi tra i partner;
- gli eventuali diritti di terzi;
- gli obblighi di riservatezza;
- la presenza di dati personali;
- le condizioni stabilite dall'ente finanziatore;
- le norme applicabili al progetto.
Per i progetti finanziati nell'ambito di Horizon Europe occorre inoltre considerare il Regolamento (UE) 2021/695, che istituisce il programma e ne stabilisce le norme di partecipazione e diffusione dei risultati della ricerca. Si consiglia inoltre di fare riferimento ai documenti:
- Università degli Studi di Palermo, Area Ricerca e Innovazione. Linee Guida DATA MANAGEMENT PLAN Horizon Europe. 2026.
- Università degli Studi di Palermo, Area Ricerca e Innovazione. Linee Guida ETICA DELLA RICERCA E OPEN SCIENCE Horizon Europe. 2026.
Cosa vuol dire Sui Generis Database Right (SGDR)?
Il Sui Generis Database Right (SGDR), o diritto sui generis sulle banche dati, è una forma specifica di tutela prevista dalla normativa dell’Unione europea per proteggere l’investimento sostenuto nella realizzazione e gestione di una banca dati. La disciplina di riferimento è la Direttiva 96/9/CE sulla tutela giuridica delle banche di dati (http://data.europa.eu/eli/dir/1996/9/2019-06-06).
Dai dati grezzi al database
Nell'ambito di un progetto di ricerca vengono prodotti o raccolti numerosi dati grezzi (raw data): misurazioni, osservazioni, immagini, registrazioni, file, documenti e altri materiali, in formato digitale o analogico. Occorre tuttavia distinguere il singolo dato dalla banca dati.
Secondo la normativa europea, una banca dati è una raccolta di opere, dati o altri elementi indipendenti, disposti in modo sistematico o metodico e individualmente accessibili; pertanto, quando un insieme di dati viene organizzato secondo criteri definiti, strutturato, verificato e corredato da informazioni descrittive, come i metadati, può costituire una vera e propria banca dati.
I dati grezzi sono protetti dal diritto d'autore?
Il semplice dato, considerato in quanto informazione o fatto, non acquista automaticamente protezione mediante il diritto d'autore. Ciò dipende dalla natura dei materiali contenuti nel dataset: una banca dati può infatti includere elementi che sono a loro volta autonomamente protetti.
La normativa europea distingue, in particolare, due possibili livelli di protezione della banca dati:
- diritto d'autore sulla struttura della banca dati;
- diritto sui generis sul contenuto della banca dati.
Le due forme di tutela possono anche coesistere, quando ricorrono i rispettivi requisiti.
Quando interviene il diritto d'autore?
Il diritto d'autore può proteggere la banca dati quando la scelta o la disposizione dei contenuti costituisce una creazione intellettuale originale dell'autore. La protezione riguarda quindi la struttura originale della banca dati, non automaticamente i singoli dati che la compongono. Ad esempio, una particolare organizzazione dei materiali, frutto di scelte originali, può essere tutelata dal diritto d'autore, mentre i dati contenuti nel database conservano il proprio regime giuridico.
Quando si applica il SGDR?
Diversamente dal diritto d'autore, il SGDR non richiede originalità o creatività. La sua funzione è proteggere l'investimento sostanziale effettuato per ottenere, verificare o presentare il contenuto della banca dati. Tale investimento può essere di natura finanziaria, materiale o umana.
In altre parole, il diritto sui generis non premia l'originalità della struttura, ma tutela il soggetto che ha sostenuto un investimento significativo nella costituzione e gestione della banca dati.
Chi è il titolare del diritto?
Il SGDR spetta al costitutore o produttore della banca dati (maker of the database), vale a dire al soggetto cui è riconducibile l'investimento sostanziale richiesto dalla normativa.
Nel contesto della ricerca questo aspetto è particolarmente importante: non si può affermare automaticamente che il diritto appartenga al singolo ricercatore o, viceversa, all'istituzione che finanzia il progetto. La titolarità deve essere valutata considerando chi abbia effettivamente assunto l'iniziativa e l'investimento rilevante nella costituzione della banca dati, oltre agli eventuali rapporti contrattuali applicabili.
Quali diritti attribuisce?
Il titolare del SGDR può impedire l'estrazione e il reimpiego della totalità o di una parte sostanziale del contenuto della banca dati. La normativa disciplina inoltre l'estrazione o il reimpiego ripetuti e sistematici di parti non sostanziali quando tali operazioni entrino in conflitto con il normale sfruttamento della banca dati o pregiudichino ingiustificatamente i legittimi interessi del costitutore.
Ciò significa che la protezione non trasforma necessariamente ogni singolo dato in un contenuto protetto: tutela piuttosto, alle condizioni previste dalla normativa, il contenuto della banca dati nel suo complesso o in parti sostanziali.
Quanto dura?
In linea generale, il diritto sui generis ha una durata di 15 anni. Il periodo decorre dalla realizzazione della banca dati oppure, in determinate circostanze, dalla sua prima messa a disposizione del pubblico.
|
Oggetto |
Tipo di tutela |
Che cosa viene protetto |
|
Singoli dati grezzi |
Non automaticamente diritto d'autore |
Il dato in quanto tale non diventa opera protetta solo perché prodotto dalla ricerca |
|
Database originale |
Diritto d'autore |
La selezione e/o disposizione originale dei contenuti |
|
Database con investimento sostanziale |
SGDR |
L'investimento nell'ottenimento, verifica o presentazione del contenuto |
|
Database originale + investimento sostanziale |
Entrambe le tutele |
Struttura originale e contenuto, secondo i rispettivi presupposti |
Machine-actionable DMP
Un machine-actionable DMP è un DMP strutturato in modo da poter essere letto, scambiato, validato e utilizzato da sistemi informatici. Non si tratta semplicemente di un documento digitale, ma di un insieme organizzato di informazioni interoperabili. Il RDA DMP Common Standard è stato sviluppato per favorire lo scambio, l’integrazione e la validazione delle informazioni contenute nei DMP tra sistemi diversi.
Il machine-actionable DMP consente di collegare il piano di gestione dei dati ad altri elementi del ciclo della ricerca, come progetti, finanziamenti, persone, organizzazioni, dataset, repository, licenze, pubblicazioni e software, eventualmente trattati e/o gestiti con altre piattaforme informatiche.
Per essere machine-actionable, il DMP dovrebbe ridurre il testo libero non controllato e utilizzare campi strutturati. Le informazioni dovrebbero essere organizzate in entità riconoscibili: progetto, finanziamento, contact point, contributor, dataset, distribuzioni, repository, costi, licenze e condizioni di accesso. Il RDA DMP Common Standard include proprio queste entità per rappresentare il contenuto informativo dei DMP lungo il ciclo di vita del progetto.
Questa struttura rende più semplice il riuso automatico delle informazioni e riduce duplicazioni e incoerenze.
Un DMP machine-actionable dovrebbe usare identificatori persistenti per collegare persone, organizzazioni, dataset, finanziamenti, repository, software e pubblicazioni, in conformità ai principi FAIR, che richiedono l’uso di identificatori globalmente univoci e persistenti per rendere dati e metadati rintracciabili (ad esempio DOI per dataset e pubblicazioni, ORCID per ricercatori, ROR per organizzazioni, grant ID per finanziamenti e identificatori dei repository).
Un DMP machine-actionable dovrebbe poter essere esportato o rappresentato in formati strutturati, ad esempio JSON, XML o RDF, e dovrebbe rispettare schemi o standard che consentano controlli automatici. La validazione può aiutare a individuare campi mancanti, identificatori non corretti, licenze assenti, date incoerenti o riferimenti non risolvibili. La validazione automatica non sostituisce la valutazione scientifica, etica o metodologica del DMP, ma ne migliora qualità e interoperabilità.
Il DMP machine-actionable deve essere aggiornabile e versionabile. Dovrebbe poter rappresentare sia azioni pianificate sia azioni già eseguite, come raccolta, elaborazione, anonimizzazione, deposito, pubblicazione, conservazione o cancellazione dei dati. Il RDA DMP Common Standard è pensato per rappresentare informazioni lungo tutto il ciclo di vita del DMP.
All'interno delle rispettive guide operative, sono presenti dettagli sulla possibilità di esportare il DMP compilato in un formato machine-readable per gli strumenti: DMP Online (vai alla guida operativa SBA UniPA), Data Stewardship wizard (vai alla guida operativa SBA UniPA), oppure ARGOS (vai alla guida operativa SBA UniPA).