

Data repository
La scelta di un repository per la pubblicazione dei dati della ricerca
La gestione deve rispettare i principi FAIR, secondo i quali i dati devono essere reperibili, accessibili, interoperabili e riutilizzabili. A questo scopo assumono particolare importanza:
- metadati ricchi, accurati e conformi agli standard disciplinari (ndr. i repository affidabili possono anche supportare i ricercatori nella scelta dei formati, nella produzione dei metadati, nella gestione dei dati sensibili, nell’anonimizzazione e nell’individuazione delle licenze più appropriate; è quindi opportuno tenerne conto fin dalle prime fasi del progetto e descrivere le scelte adottate nel Data Management Plan);
- formati aperti o adeguatamente documentati;
- identificativi persistenti, come DOI e URN:NBN: alcuni repository, come ad esempio Zenodo, rilasciano gratuitamente un DOI;
- documentazione sufficiente a comprendere e riutilizzare i dati;
- licenze chiare, preferibilmente CC0 o CC BY per i dati aperti (ndr. OpenAIRE raccomanda l’adozione della licenza Creative Commons CC0 o CC-BY, a meno che non ci siano limitazioni particolari, ad esempio in caso di dati sensibili o di dati coperti da segreto militare. L’EUDAT License Selector è un wizard che può aiutare nella scelta della licenza. Sia l'attribuzione di un identificativo unico persistente che di una licenza d’uso sono servizi offerti dai data repository certificati);
- indicazione esplicita delle condizioni e delle eventuali limitazioni di accesso.
Per scegliere il repository, la guida suggerisce di privilegiare, nell’ordine, un repository disciplinare, un repository istituzionale idoneo oppure un repository multidisciplinare come Zenodo (ndr. che non ha la certificazione Core Trust Seal ma è considerato “trusted” da OpenAIRE). In alternativa, è possibile utilizzare registri come re3data e FAIRsharing, verificando la presenza di certificazioni, politiche di conservazione, standard per i metadati, identificativi persistenti e condizioni di accesso trasparenti. Altri esempi di repositories possono essere ritrovati in OpenDOAR, la Directory of Open Access Repositories. Un ruolo centrale è attribuito ai Trustworthy Digital Repositories, ossia repository che garantiscono integrità, autenticità, accessibilità e conservazione a lungo termine dei dati. Il quadro europeo richiama tre principali livelli di certificazione: CoreTrustSeal, Nestor Seal e ISO 16363.
Esistono diversi tipi di certificazioni standard a livello internazionale dedicate agli archivi digitali. In ambito europeo, le certificazioni disponibili sono:
- CoreTrustSeal (CTS): basata sul Data Seal of Approval (DSA) e sul World Data System (WDS) van ICSU. La lista degli archivi in possesso di tale certificazione può essere consultata all’URL https://www.coretrustseal.org/why-certification/certified-repositories/.
- Nestor Seal: principalmente per la Germania, in conformità con lo standard DIN 31644
- La certificazione ISO 16363 (ad oggi non ancora utilizzata in Europa e in Italia).
I repository certificati impongono regole più stringenti a chi deposita, proprio perché i requisiti per la certificazione prevedono l’adesione ai principi FAIR di gestione dei dati, secondo il principio dettato dalla Commissione Europea “FAIR data in trustworthy repositories”.
dalla pagina What are these repository certifications based on?
Ecco i principali requisiti a cui un repository certificato CoreTrustSeal deve conformarsi. I passaggi in corsivo evidenziano il chiaro collegamento con i principi FAIR dei dati. Questi requisiti sono strettamente allineati ai principi FAIR e supportano l'obiettivo della Commissione Europea di garantire “dati FAIR in repository affidabili”. Ricorda: la Commissione Europea promuove dati FAIR conservati in repository affidabili. Ricercatori e repository affidabili sono partner nella gestione di dati aperti e FAIR.
Requisito 1 (R1)
Il repository mantiene tutte le licenze applicabili che disciplinano l'accesso e l'utilizzo dei dati e ne monitora il rispetto. Ciò garantisce chiarezza sulle condizioni di riutilizzo e supporta il principio di Riutilizzabilità (Reusability, R) dei FAIR.
Requisito 2 (R2)
Il repository dispone di un piano di continuità che assicura l'accesso e la conservazione a lungo termine delle proprie risorse. Ciò garantisce l'accessibilità e la sostenibilità dei dati della ricerca nel lungo periodo.
Requisito 3 (R3)
Il repository assicura, per quanto possibile, che i dati siano creati, curati, consultati e utilizzati nel rispetto delle norme disciplinari ed etiche. Ciò include il rispetto di quadri normativi e regolamentari, come il GDPR, e degli standard della comunità scientifica di riferimento.
Requisito 4 (R4)
Il repository garantisce l'integrità e l'autenticità dei dati. Questo assicura che i dati rimangano affidabili e attendibili nel tempo.
Requisito 5 (R5)
Il repository accetta dati e metadati sulla base di criteri definiti, al fine di garantirne la pertinenza e la comprensibilità per gli utilizzatori. Ciò include requisiti relativi a metadati ricchi e strutturati e a un'adeguata documentazione.
Requisito 6 (R6)
Il repository si assume la responsabilità della conservazione a lungo termine e gestisce questa funzione in modo pianificato e documentato. Questo riflette il ruolo fondamentale dei repository nel garantire l'usabilità dei dati nel lungo periodo.
Requisito 7 (R7)
Il repository possiede competenze adeguate per affrontare gli aspetti tecnici relativi alla qualità dei dati e dei metadati e assicura che gli utenti finali dispongano di informazioni sufficienti per effettuare valutazioni sulla qualità dei dati. Questo evidenzia il ruolo dei repository nel supportare la qualità dei dati, gli standard per i metadati e l'assistenza agli utenti.
Requisito 8 (R8)
Il repository consente agli utenti di individuare i dati e di farvi riferimento in modo persistente attraverso una corretta citazione. Questo obiettivo viene solitamente raggiunto mediante l'uso di Identificatori Persistenti (PID), a supporto del principio di Reperibilità (Findability, F).
Requisito 9 (R9)
Il repository consente il riutilizzo dei dati nel tempo, garantendo la disponibilità di metadati adeguati a supportarne la comprensione e l'utilizzo. Ciò sostiene direttamente il principio di Riutilizzabilità (Reusability, R) attraverso licenze, documentazione e metadati appropriati.
Lo sapevi?
CoreTrustSeal comprende 16 requisiti fondamentali per i repository affidabili. Tali requisiti riguardano aspetti quali l'integrità dei dati, l'accesso, la conservazione, la governance e il riutilizzo, garantendo la coerenza con i principi FAIR. CoreTrustSeal Requirements
Lo sapevi?
I requisiti di certificazione sono strettamente allineati ai principi FAIR. Essi garantiscono che i dati siano:
- Reperibili (Findable) attraverso PID e metadati;
- Accessibili (Accessible) mediante politiche chiare;
- Interoperabili (Interoperable) grazie all'adozione di standard;
- Riutilizzabili (Reusable) attraverso licenze e documentazione adeguate.
The FAIR Guiding Principles for scientific data management and stewardship, https://doi.org/10.1038/sdata.2016.18
Lo sapevi?
I Repository Digitali Affidabili (Trustworthy Digital Repositories) sono essenziali per l'EOSC (European Open Science Cloud). Essi forniscono l'infrastruttura necessaria affinché i dati della ricerca rimangano accessibili, utilizzabili e di valore nel tempo, supportando la riproducibilità e il riutilizzo della ricerca. EOSC Long-Term Data Preservation Task Force Report, https://doi.org/10.5281/zenodo.7034315
Riferimenti
- CoreTrustSeal Requirements [https://ww...uirements/]
- The FAIR Guiding Principles for scientific data management and stewardship [https://do...ta.2016.18]
- EOSC Long-Term Data Preservation Task Force Report
I criteri di selezione
Uno dei pilastri della ricerca scientifica riproducibile è l’esposizione pubblica dei dati. Gli Enti finanziatori, le istituzioni, gli editori chiedono ai ricercatori di depositare i dati della ricerca in repositories dedicati. I ricercatori, quindi, hanno l’esigenza di identificare dei repository affidabili, che consentano loro di depositare i dati e renderli disponibili alla comunità scientifica e alla società.
La maggior parte dei repositories non è certificata da un ente di certificazione accreditato, per cui identificarne uno appropriato è una grande sfida: alcuni repositories potranno offrire policy e standard specifici per la comunità scientifica di riferimento, altri potranno essere più generalisti.
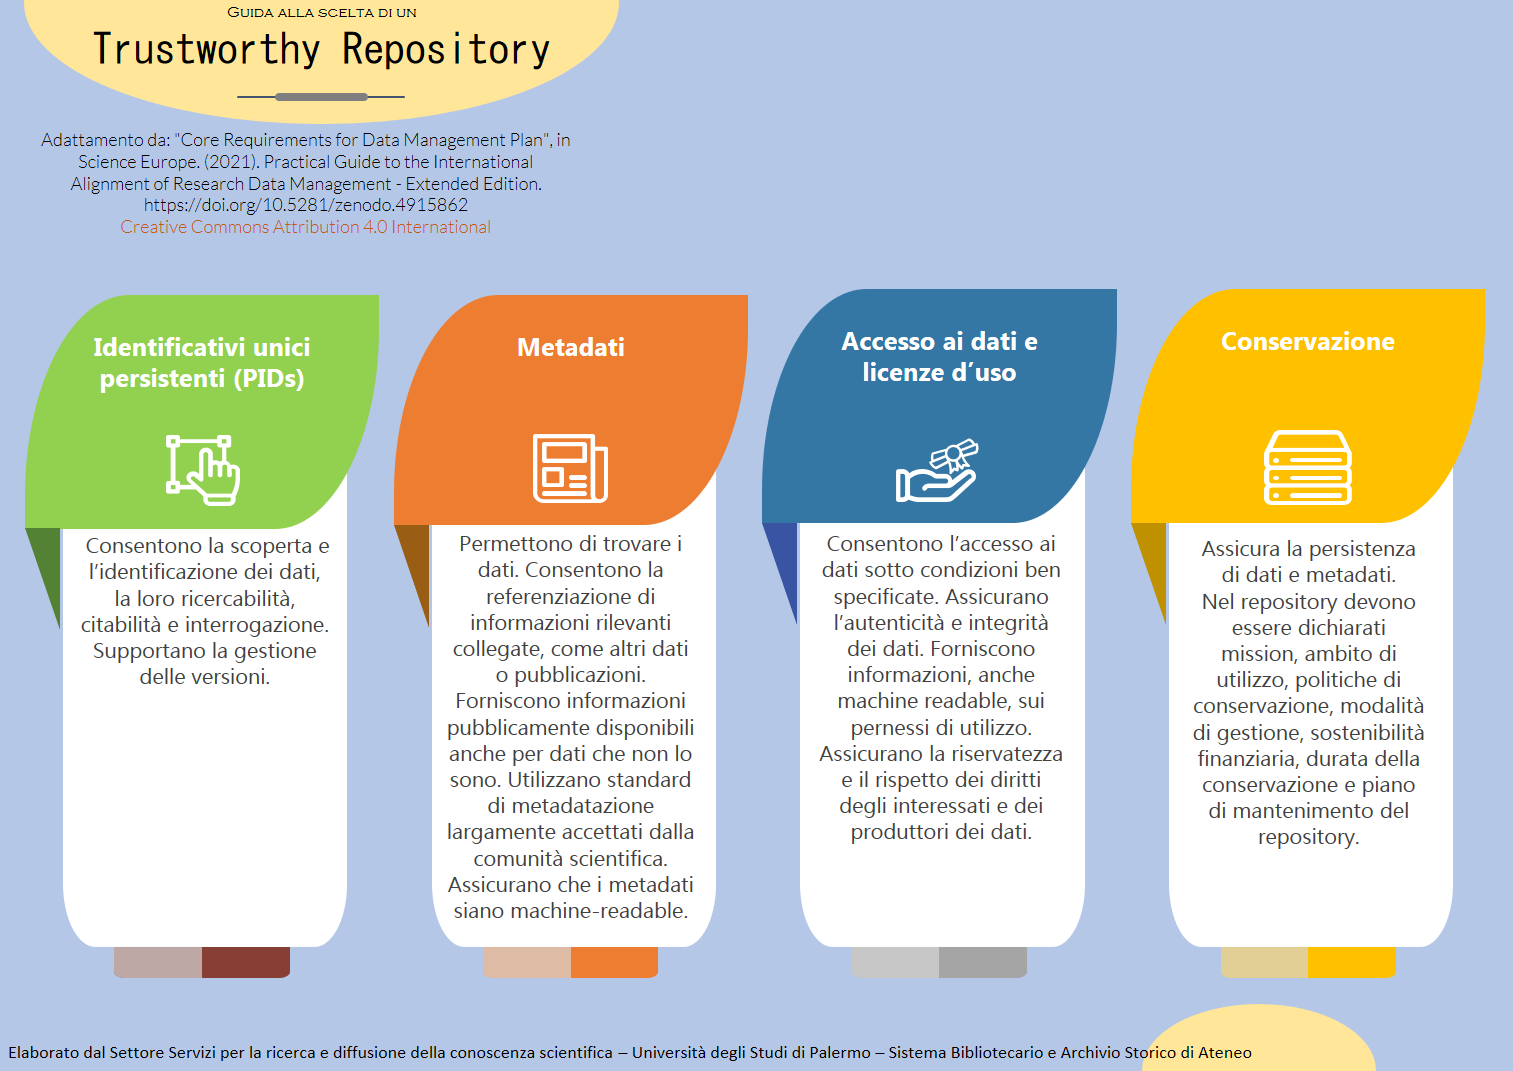
Di seguito si elencano i criteri di selezione raccomandati, come descritto nel documento : "Core Requirements for Data Management Plan", in Science Europe. (2021). Practical Guide to the International Alignment of Research Data Management - Extended Edition. https://doi.org/10.5281/zenodo.4915862, Creative Commons Attribution 4.0 International, di cui il grafico e la tabella seguenti rappresentano una traduzione e adattamento.
.
|
Di seguito alcuni criteri guida per la selezione di repository affidabili. |
|
 |
Identificativiunicipersistenti (PIDs)
Un repository affidabile dovrebbe: •Consentire la «scoperta» e l’identificazione dei dati, quindi assicurati che tra i metadati siano previsti identificativi unici persistenti (PId).
•Rendere possibile ricercare, citare e interrogare i dati, assegnando identificativi unici persistenti ai dati che contiene, permettendo ai dati e ai metadati corrispondenti di essere trovati, citati e interrogati anche se fisicamente dovessero cambiare collocazione.
•Fornire supporto per il data versioning, cioè assicurare che la versione dei dati ospitati sia chiaramente specificata, documentata e tracciata.
Nota: non tutti i repositories usano un sistema di attribuzione del PID universalmente accettato, ma utilizzano un identificativo gestito localmente. Ciò aumenta il rischio che, in caso di loro trasferimento ad altro sistema, perché il repository non esiste più o ha cambiato organizzazione che lo gestisce, i dati non possano essere più ritrovati. |
 |
Metadati
I dati dovrebbero essere descritti con numerosi metadati che documentino come sono stati generati, sotto quale licenza e come potranno essere riutilizzati; i metadati devono contenere le informazioni di contesto che consentano ad altri ricercatori di interpretarli appropriatamente. Un repository affidabile dovrebbe: •Consentire di trovare i dati, assicurando l’interoperabilità e il riutilizzo, fornendo i dati e i metadati in un linguaggio accessibile, basato su un ben determinato formalismo. I dati e i metadati dovrebbero essere descritti utilizzando vocabolari controllati e formati che consentano di cercarli, combinarli in modo automatico e distinguere i metadati dai dati.
•Consentire la referenziazione ad informazioni rilevanti correlate, assicurando che tra i metadati sia possibile dichiarare link a informazioni rilevanti o associate, inserendo un identificativo unico persistente e la relativa descrizione. Un particolare tipo di informazione riguarda i ricercatori, per cui esistono identificativi persistenti (ID) come ORCID o altri.
•Fornire informazioni pubblicamente disponibili anche per dati non pubblici, assicurando la conservazione a lungo termine dei metadati e la loro ricercabilità, anche se i dati non sono disponibili per motivi di protezione dati, vincoli legali o misure di sicurezza, e assicurando che anche i dati ritrattati a causa di cattive condotte di ricerca o altro siano sempre disponibili per consentire l’esame del lavoro di ricerca.
•Utilizzare per i metadati standard che siano largamente accettati dalla comunità scientifica, assicurando che i dati mantenuti nel repository siano machine-retrievable (reperibili con strumenti informatici), e assicurando che siano utilizzati standard e buone pratiche per la gestione dei dati, se esistono, facendo attenzione a standard specifici per particolari ambiti di ricerca.
•Assicurare che i metadati siano machine-readable, incoraggiando l’adozione di strutture per i metadati che consentano di leggerli con strumenti informatici, ad esempio mettendo a disposizione dei form da compilare con specifici campi obbligatori.
|
 |
Accesso ai dati e licenze d’uso
Unrepository affidabile dovrebbe: •Consentire l’accesso ai dati sotto ben specificate condizioni, i cui termini di riutilizzo devono essere descritti in modo chiaro. Le informazioni sulla licenza devono essere incluse nei metadati.
•Assicurare l’autenticità ed integrità dei dati, assicurando che i metadati contengano informazioni dettagliate sulla provenienza dei dati, le modalità di creazione e di elaborazione, in quale contesto possono essere riutilizzati e quanto sono affidabili.
•Consentire il recupero dei dati o almeno dei metadati utilizzando un protocollo aperto e standardizzato (non un protocollo di comunicazione proprietario).
•Fornire informazioni sulle licenze e i permessi (in un formato machine-readable), permettendo l’accesso alle informazioni sulle licenze in modo strutturato, perché le condizioni di utilizzo siano chiare, sia alle persone che ai computer. Ove possibile, dovrebbero essere utilizzati sistemi di licensing largamente accettati (ad esempio Creative Commons) e che possano essere referenziati tramite URL.
•garantire la riservatezza e i diritti degli interessati e dei creatori dei dati, fornendo un sistema di autenticazione e profilazione sia per utenti che sistemi software, consentendo di impostare diritti di accesso che tengano conto dei dati con problemi di riservatezza e di altre restrizioni.
|
 |
Conservazione Unrepository affidabile dovrebbe: •Assicurare la persistenza di metadati e dati, assicurandone continuativamente disponibilità ed accesso.
•Essere trasparente su missione, ambito, politiche di conservazione, pianificazioni (su governance, sostenibilità finanziaria, periodo di conservazione e piano di continuità), fornendo evidenza in maniera documentata anche di partner esterni per la gestione tecnica e fornendo informazioni su come verrebbero trasferiti i dati in caso di cessazione del repository.
|
Alcune piattaforme software di gestione repository dei dati della ricerca
I repository di dati, disciplinari, istituzionali, commerciali, si appoggiano a svariate piattaforme software, che possono essere prese in considerazione in caso di installazioni locali o per meglio scegliere una piattaforma commerciale per avviare un repository istituzionale.
I repository consentono di depositare, descrivere, conservare e pubblicare i dati della ricerca. Le principali funzionalità delle piattaforme di gestione dei repository comprendono la gestione dei metadati, il controllo degli accessi, il versionamento, l’attribuzione di identificatori persistenti e l’integrazione con servizi come ORCID, DataCite e OpenAIRE.
Dataverse è una piattaforma open source progettata specificamente per i dati della ricerca. Supporta metadati disciplinari, versionamento, citazione e gestione degli accessi ed è particolarmente adatta alla realizzazione di repository istituzionali o tematici.
InvenioRDM, basata sull’esperienza di Zenodo, è una soluzione open source moderna e scalabile. Offre API, gestione di community, autenticazione istituzionale e integrazione con le principali infrastrutture dell’Open Science. È indicata per istituzioni con disponibilità di competenze tecniche e necessità di gestire grandi quantità di dati.
DSpace è uno dei software più diffusi per i repository istituzionali. Può gestire pubblicazioni, tesi, dataset e altri prodotti della ricerca, ma per una gestione avanzata dei dati può richiedere configurazioni e personalizzazioni specifiche.
Fedora Repository è un’infrastruttura open source flessibile, adatta alla gestione di oggetti digitali complessi e alla conservazione a lungo termine. Richiede tuttavia competenze tecniche elevate e l’integrazione con interfacce o applicazioni aggiuntive.
CKAN è utilizzato soprattutto per portali e cataloghi di open data. Offre metadati, ricerca e API, ma è meno specializzato nella curatela e nel ciclo di vita dei dati scientifici.
Figshare è una soluzione commerciale in cloud che consente di pubblicare e condividere dati e altri prodotti della ricerca. Riduce gli oneri tecnici a carico dell’istituzione, ma comporta costi contrattuali e una maggiore dipendenza dal fornitore.
Nel contesto universitario, la scelta non dovrebbe basarsi soltanto sul software, ma su un modello di servizio condiviso tra Sistema bibliotecario, area ricerca, sistemi informativi, ufficio legale, DPO e strutture scientifiche. È necessario valutare almeno:
- integrazione con autenticazione di ateneo, ORCID, DataCite, OpenAIRE e sistemi CRIS;
- assegnazione di DOI e gestione del versionamento;
- metadati generali e disciplinari;
- embargo, accessi riservati e gestione dei dati personali;
- API, interoperabilità e possibilità di esportazione dei dati;
- dimensione massima dei dataset e costi dello storage;
- conservazione a lungo termine e procedure di backup;
- disponibilità di data steward e personale addetto alla curatela;
- sostenibilità economica e tecnologica nel medio-lungo periodo.
Per un ateneo che voglia realizzare un repository specificamente dedicato ai dati della ricerca, Dataverse e InvenioRDM rappresentano le opzioni open source più coerenti. DSpace può essere una scelta sostenibile quando è già utilizzato come repository istituzionale, purché venga adeguatamente configurato per i dataset. Figshare consente invece un’attivazione più rapida, mentre Fedora Repository e CKAN rispondono a esigenze più specialistiche o complementari.